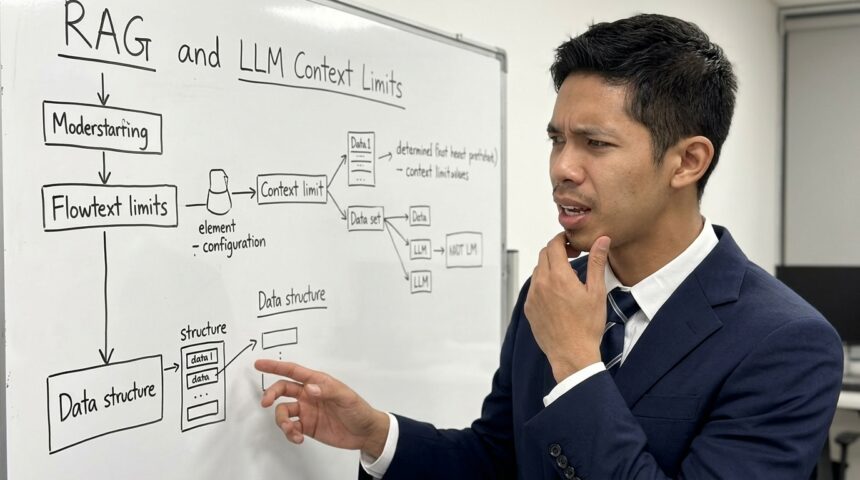
Dunia kecerdasan buatan atau Artificial Intelligence saat ini tengah mengalami transformasi besar dengan hadirnya teknik yang dikenal sebagai Retrieval-Augmented Generation atau yang lebih populer dengan singkatan RAG. Teknologi ini muncul sebagai jawaban atas keterbatasan model bahasa besar (LLM) dalam mengakses informasi terkini atau data privat yang tidak ada dalam database pelatihannya. Secara mendasar, RAG adalah sebuah pola di mana aplikasi mengambil materi sumber yang relevan dan menambahkannya ke dalam prompt model sehingga model tersebut dapat memberikan jawaban berdasarkan konteks yang diberikan secara spesifik. Namun, di balik kecanggihannya, para pengembang sering kali terbentur oleh dinding pembatas yang cukup mengganggu, yakni limitasi atau batasan pada context window yang dimiliki oleh setiap model AI.
Context window adalah kapasitas maksimal informasi yang dapat diproses oleh model dalam satu waktu, dan jika informasi yang dimasukkan melebihi batas ini, model akan mulai kehilangan detail atau bahkan gagal memberikan jawaban yang akurat. Memahami cara mengelola batasan ini bukan sekadar urusan teknis, melainkan sebuah seni dalam memastikan bahwa AI tetap cerdas tanpa harus membebani sistem dengan data yang berlebihan. Artikel ini akan mengupas tuntas bagaimana strategi terbaik dalam menangani keterbatasan jendela konteks pada sistem RAG agar performa aplikasi tetap optimal dan respons yang dihasilkan tetap tajam serta relevan. Kita akan melihat mengapa efisiensi dalam pemilihan data menjadi kunci utama dalam memenangkan persaingan di era AI generatif yang semakin kompetitif ini.
Apa Itu RAG dan Mengapa Ia Menjadi Standar Baru di Dunia AI?
Untuk memahami urgensi penanganan context window, kita harus terlebih dahulu menyelami esensi dari Retrieval-Augmented Generation itu sendiri sebagai sebuah arsitektur modern. RAG bekerja dengan cara menjembatani kesenjangan antara pengetahuan statis yang dimiliki model saat fase pelatihan dengan kebutuhan akan data yang dinamis dan spesifik. Dalam skenario penggunaan nyata, aplikasi akan melakukan pencarian ke dalam database eksternal untuk menemukan dokumen atau potongan teks yang paling berkaitan dengan pertanyaan pengguna. Setelah informasi tersebut ditemukan, sistem akan menyematkannya ke dalam instruksi yang dikirimkan ke model, sehingga AI seolah-olah memiliki ‘buku panduan’ instan untuk menjawab pertanyaan tersebut dengan sangat akurat.
Keunggulan utama dari pola RAG ini adalah kemampuannya untuk mengurangi halusinasi pada AI, karena model dipaksa untuk merujuk pada fakta yang disediakan dalam konteks, bukan hanya mengandalkan prediksi probabilitas kata semata. Hal ini menjadikan RAG sebagai standar emas bagi perusahaan yang ingin membangun chatbot layanan pelanggan, asisten riset, hingga alat analisis dokumen hukum yang memerlukan tingkat presisi tinggi. Namun, tantangan muncul ketika materi sumber yang ditemukan sangat banyak, sementara ‘ruang baca’ atau context window milik model sangat terbatas. Di sinilah optimasi sistem menjadi sangat krusial agar informasi yang paling penting tidak terbuang sia-sia karena keterbatasan teknis tersebut.
Mekanisme Pengambilan Data dalam RAG
Mekanisme pengambilan data atau retrieval dalam sistem RAG biasanya melibatkan proses yang disebut vector search atau pencarian vektor yang sangat efisien. Setiap dokumen akan diubah menjadi representasi angka atau embedding yang memungkinkan sistem untuk menghitung kemiripan semantik antara pertanyaan pengguna dengan data yang tersedia. Ketika kecocokan ditemukan, potongan-potongan informasi tersebut akan ditarik untuk kemudian disusun kembali menjadi bagian dari prompt akhir. Hingga saat ini, efektivitas sistem RAG sangat bergantung pada seberapa baik proses pengambilan data ini dilakukan sebelum akhirnya diserahkan kepada model generatif.
Menembus Batas: Memahami Kendala Context Window pada Model Bahasa
Setiap model bahasa, mulai dari yang berukuran kecil hingga yang raksasa, memiliki batasan fisik yang disebut sebagai context window, yang diukur dalam satuan token. Token ini bisa berupa kata, bagian dari kata, atau tanda baca, dan setiap model memiliki limitasi yang berbeda-beda tergantung pada arsitektur pengembangannya. Masalah utama muncul ketika dokumen yang ingin kita masukkan ke dalam sistem RAG jauh lebih besar daripada kapasitas yang bisa diterima oleh model tersebut dalam satu kali proses. Jika kita memaksakan semua data masuk, model akan mengalami ‘overflow’ yang mengakibatkan informasi di bagian awal atau tengah sering kali diabaikan, sebuah fenomena yang dikenal sebagai lost in the middle.
Keterbatasan jendela konteks ini memaksa para insinyur perangkat lunak untuk berpikir kreatif dalam menyaring informasi mana yang benar-benar layak untuk disajikan kepada model. Kita tidak bisa sekadar melemparkan seluruh isi buku ke dalam prompt jika model hanya mampu membaca beberapa halaman saja dalam satu waktu. Oleh karena itu, efisiensi menjadi mata uang yang sangat berharga dalam pengembangan aplikasi berbasis Generative AI yang menggunakan pola RAG. Mengabaikan batasan ini tidak hanya akan menurunkan kualitas jawaban, tetapi juga dapat meningkatkan biaya operasional secara signifikan karena penggunaan token yang tidak perlu pada model yang berbayar.
Mengapa Ukuran Jendela Konteks Sangat Krusial?
Ukuran jendela konteks sangat krusial karena ia menentukan seberapa banyak latar belakang yang bisa dipahami oleh AI sebelum ia memberikan respons. Jendela yang terlalu sempit akan membuat AI tampak ‘pelupa’ atau tidak mampu menghubungkan poin-poin informasi yang tersebar di berbagai bagian dokumen. Di sisi lain, meskipun teknologi terbaru mulai menawarkan jendela konteks yang sangat besar, biaya komputasi dan latensi atau kecepatan respons tetap menjadi pertimbangan utama. Oleh karena itu, strategi penanganan limitasi ini tetap menjadi topik hangat yang terus dikembangkan oleh para praktisi di seluruh dunia.
Strategi Teknis Mengelola Data dengan Context Window Terbatas
Salah satu cara paling efektif untuk menangani limitasi context window dalam sistem RAG adalah dengan menerapkan teknik chunking atau segmentasi data yang cerdas. Daripada memasukkan dokumen utuh, data dipecah menjadi potongan-potongan kecil yang berdiri sendiri namun tetap mengandung makna yang utuh. Potongan-potongan ini kemudian disimpan dalam vector database dan hanya bagian yang paling relevan saja yang akan dipanggil saat dibutuhkan oleh sistem. Dengan cara ini, kita bisa memastikan bahwa setiap token yang masuk ke dalam context window adalah informasi yang benar-benar memberikan nilai tambah bagi jawaban yang akan dihasilkan oleh model.
Selain chunking, pengaturan strategi overlap antar potongan data juga sangat penting untuk menjaga agar konteks tidak terputus di tengah kalimat. Dengan memberikan sedikit irisan informasi antara satu potongan dengan potongan berikutnya, model dapat memahami kesinambungan narasi meskipun data tersebut diberikan secara terpisah-pisah. Teknik ini terbukti sangat ampuh dalam menjaga akurasi sistem RAG pada dokumen yang memiliki struktur kompleks seperti laporan keuangan atau manual teknis perangkat keras. Belum ada konfirmasi resmi mengenai standar ukuran chunk yang ideal untuk semua model, namun eksperimen biasanya menunjukkan bahwa ukuran antara 500 hingga 1000 token adalah titik keseimbangan yang baik.
Teknik Chunking dan Segmentasi Data
- Fixed-size chunking: Membagi teks berdasarkan jumlah karakter atau token yang tetap secara konsisten.
- Recursive character splitting: Memecah teks berdasarkan struktur bahasa seperti paragraf atau kalimat untuk menjaga keutuhan makna.
- Semantic chunking: Menggunakan model AI lain untuk menentukan di mana sebuah topik berakhir dan topik baru dimulai dalam sebuah teks.
Re-ranking: Memastikan Hanya Informasi Paling Relevan yang Masuk
Setelah sistem melakukan pencarian awal dan mendapatkan sejumlah potongan dokumen, langkah selanjutnya yang sangat krusial adalah proses re-ranking. Sering kali, pencarian vektor memberikan hasil yang secara angka terlihat mirip namun secara substansi kurang relevan bagi kebutuhan pengguna. Dengan menerapkan lapisan re-ranking, kita bisa menyaring kembali hasil-hasil tersebut dan mengurutkannya berdasarkan tingkat relevansi yang lebih mendalam. Hanya hasil peringkat terataslah yang kemudian akan dimasukkan ke dalam context window yang terbatas, sehingga kualitas prompt menjadi jauh lebih padat dan bermutu.
Proses re-ranking ini bertindak sebagai filter kualitas yang memastikan bahwa ruang terbatas di dalam jendela konteks tidak disia-siakan oleh informasi sampah atau data yang hanya sekadar mirip secara kata kunci. Dalam banyak kasus, penggunaan model re-ranker yang lebih kecil dan cepat dapat meningkatkan performa sistem secara keseluruhan tanpa menambah beban latensi yang berarti. Strategi ini sangat direkomendasikan bagi aplikasi yang menangani ribuan hingga jutaan dokumen, di mana hasil pencarian awal mungkin terlalu luas untuk langsung diproses oleh model generatif utama. Dengan re-ranking, kita bisa memaksimalkan potensi setiap token yang tersedia dalam batas limitasi model.
Peran Penting Metadata dalam Mempercepat Pencarian Konteks
Selain mengandalkan isi teks semata, penggunaan metadata atau data tentang data menjadi strategi yang sangat cerdas dalam mengoptimalkan penggunaan context window. Dengan menyertakan informasi tambahan seperti tanggal dokumen, kategori, penulis, atau label spesifik lainnya, sistem RAG dapat melakukan filter awal sebelum pencarian semantik dilakukan. Hal ini secara drastis mengurangi jumlah data yang perlu dipertimbangkan dan memastikan bahwa konteks yang ditarik berasal dari sumber yang memang benar-benar diinginkan oleh pengguna. Metadata bertindak sebagai kompas yang mengarahkan sistem langsung ke gudang informasi yang tepat tanpa harus menggeledah seluruh isi perpustakaan digital.
Sebagai contoh, jika seorang pengguna menanyakan tentang laporan penjualan tahun 2023, sistem yang didukung metadata tidak akan membuang-buang ruang context window dengan menarik data dari tahun 2021 atau 2022. Efisiensi semacam ini sangat membantu dalam menjaga agar prompt tetap ringkas namun sangat tepat sasaran. Pengembang yang sukses biasanya menghabiskan waktu yang cukup lama untuk merancang struktur metadata yang baik karena mereka tahu bahwa inilah kunci untuk skalabilitas sistem AI di masa depan. Tanpa metadata yang kuat, sistem RAG berisiko memberikan jawaban yang benar secara bahasa namun salah secara konteks waktu atau kategori.
Dampak Implementasi RAG yang Efisien bagi Masa Depan Teknologi
Implementasi strategi penanganan context window yang matang akan membawa dampak yang sangat luas bagi ekosistem teknologi informasi secara global. Bagi pelaku industri, hal ini berarti penghematan biaya yang signifikan karena efisiensi penggunaan token pada platform AI berbayar. Selain itu, pengalaman pengguna juga akan meningkat drastis berkat respons AI yang lebih cepat, lebih akurat, dan lebih relevan terhadap kebutuhan spesifik mereka. Kita sedang bergerak menuju masa depan di mana AI bukan lagi sekadar alat pencari informasi, melainkan asisten cerdas yang mampu memahami konteks yang sangat detail sekalipun dengan keterbatasan infrastruktur yang ada.
Di sisi lain, perkembangan teknik optimasi RAG ini juga mendorong para pengembang model AI untuk terus berinovasi dalam menciptakan arsitektur yang lebih efisien dalam menangani konteks yang panjang. Persaingan antar penyedia model tidak lagi hanya berfokus pada seberapa besar parameter yang mereka miliki, tetapi juga seberapa cerdas mereka dalam mengelola memori dan perhatian (attention mechanism). Dengan penanganan yang tepat, batasan context window yang dulunya dianggap sebagai hambatan besar kini justru menjadi tantangan yang memicu lahirnya berbagai inovasi teknik pengolahan data yang lebih canggih dan elegan.
Kesimpulan dan Pandangan ke Depan Mengenai Sistem RAG
Sebagai penutup, tantangan dalam menghadapi batasan context window pada sistem Retrieval-Augmented Generation bukanlah sesuatu yang harus ditakuti, melainkan harus dikelola dengan strategi yang tepat. Melalui kombinasi teknik chunking yang cerdas, proses re-ranking yang ketat, serta pemanfaatan metadata yang optimal, pengembang dapat menciptakan aplikasi AI yang sangat kuat meskipun bekerja dalam keterbatasan ruang memori. RAG telah membuktikan dirinya sebagai pola arsitektur yang paling tangguh dalam menghadirkan informasi yang akurat dan berbasis fakta kepada pengguna akhir, menjadikannya komponen tak terpisahkan dalam pengembangan perangkat lunak modern.
Ke depan, kita dapat mengharapkan adanya integrasi yang lebih dalam antara database vektor dengan model bahasa, yang mungkin akan meminimalkan kebutuhan akan pengaturan manual pada context window. Namun, hingga saat itu tiba, kemahiran dalam mengoptimalkan setiap bit informasi yang masuk ke dalam prompt tetap akan menjadi keahlian yang sangat dicari di industri teknologi. Dengan terus mengikuti perkembangan terbaru dan menerapkan praktik terbaik dalam manajemen konteks, kita dapat memastikan bahwa potensi penuh dari Generative AI dapat dinikmati oleh semua orang tanpa terkecuali, membawa kita lebih dekat ke era asisten digital yang benar-benar memahami dunia sebagaimana adanya.