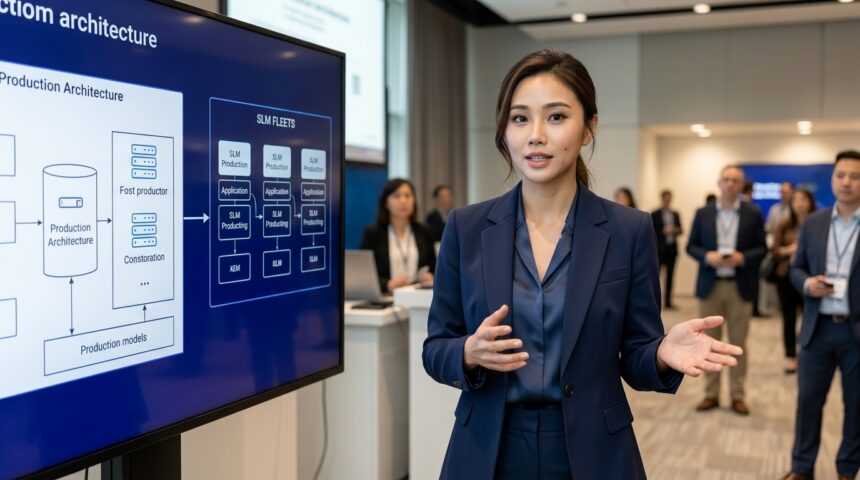
Dunia kecerdasan buatan saat ini sedang mengalami pergeseran paradigma yang sangat signifikan, di mana fokus industri mulai beralih dari model bahasa raksasa menuju Small Language Model (SLM) yang lebih spesifik dan efisien. Fenomena ini muncul karena kebutuhan mendesak akan aplikasi yang mampu beroperasi secara real-time dengan throughput yang sangat tinggi tanpa membebani infrastruktur secara berlebihan. Selama ini, para pengembang dan peneliti AI telah mencapai tingkat kemahiran yang luar biasa dalam melakukan fine-tuning terhadap model-model kecil ini agar sesuai dengan kebutuhan spesifik bisnis. Namun, sebuah hambatan besar muncul ketika model-model yang sudah dioptimalkan tersebut harus dijalankan dalam lingkungan produksi yang sesungguhnya. Kita seolah berada di persimpangan jalan di mana kemampuan teknis untuk menyempurnakan model tidak sebanding dengan kemudahan dalam mengelola arsitektur produksinya secara massal.
Membangun arsitektur yang kokoh untuk mengelola armada atau fleets dari Small Language Model memerlukan pendekatan yang jauh berbeda dibandingkan dengan mengelola satu model besar tunggal. Tantangan utamanya bukan lagi sekadar akurasi prediksi, melainkan bagaimana mengorkestrasi banyak model kecil tersebut agar bekerja secara harmonis dalam sistem yang kompleks. Artikel ini akan membedah secara mendalam bagaimana membangun arsitektur produksi yang mampu menangani beban kerja tinggi, memastikan latensi rendah, dan tetap menjaga efisiensi biaya operasional. Pemahaman mendalam mengenai struktur ini menjadi krusial bagi perusahaan yang ingin beralih dari sekadar eksperimen laboratorium menuju implementasi AI yang berdampak nyata bagi bisnis mereka.
Pergeseran Paradigma dari LLM Raksasa ke Small Language Model (SLM)
Tren penggunaan Small Language Model (SLM) tidak muncul begitu saja tanpa alasan yang kuat di baliknya. Model-model besar memang memiliki kapabilitas generalis yang luar biasa, namun mereka seringkali terlalu lambat dan terlalu mahal untuk aplikasi yang membutuhkan respons instan dalam hitungan milidetik. Dalam konteks aplikasi high-throughput, penggunaan model besar seringkali menjadi tidak praktis karena konsumsi sumber daya komputasi yang sangat masif. Oleh karena itu, para pengembang mulai melirik SLM yang memiliki parameter lebih sedikit namun telah dilatih secara khusus untuk tugas-tugas tertentu yang sangat spesifik.
Keunggulan Efisiensi dan Kecepatan
Salah satu alasan utama mengapa SLM menjadi primadona baru adalah kemampuannya untuk dijalankan pada perangkat keras yang lebih terjangkau dengan kecepatan yang mengagumkan. Dengan jumlah parameter yang lebih kecil, model-model ini dapat melakukan proses inferensi jauh lebih cepat dibandingkan rekan-rekan mereka yang berukuran besar. Hal ini sangat krusial bagi layanan pelanggan otomatis, analisis data real-time, dan sistem rekomendasi yang membutuhkan umpan balik seketika. Efisiensi ini memungkinkan perusahaan untuk memproses lebih banyak permintaan pengguna dalam waktu yang bersamaan tanpa harus menyewa kluster GPU yang sangat mahal.
Kustomisasi Melalui Fine-Tuning yang Presisi
Meskipun ukurannya kecil, SLM memiliki fleksibilitas yang sangat tinggi untuk dipersonalisasi sesuai dengan domain data tertentu. Melalui proses fine-tuning, model kecil ini dapat dilatih untuk memahami terminologi industri medis, hukum, atau teknis dengan tingkat akurasi yang menyamai model besar. Kemampuan untuk menyempurnakan model dengan dataset yang relatif kecil namun berkualitas tinggi menjadikannya solusi yang sangat menarik bagi sektor-sektor yang memiliki batasan privasi data ketat. Dengan melakukan fine-tuning secara lokal, perusahaan dapat menjaga kedaulatan data mereka tanpa harus mengirimkan informasi sensitif ke penyedia layanan AI pihak ketiga.
Tantangan Mengelola ‘Model Fleets’ dalam Skala Produksi
Meskipun kita telah sangat mahir dalam melakukan fine-tuning, transisi menuju manajemen armada model atau model fleets menghadirkan kompleksitas baru yang seringkali tidak terduga. Mengelola satu model mungkin terlihat sederhana, namun ketika sebuah sistem harus mengoordinasikan puluhan atau bahkan ratusan SLM yang berbeda secara bersamaan, masalah skalabilitas mulai muncul ke permukaan. Belum ada konfirmasi resmi mengenai standar industri yang baku untuk hal ini, namun para praktisi mulai menyadari bahwa pendekatan tradisional dalam deployment model AI tidak lagi memadai untuk menangani ekosistem SLM yang heterogen.
Kompleksitas Orkestrasi dan Alokasi Sumber Daya
Dalam sebuah arsitektur produksi yang melibatkan banyak SLM, setiap model mungkin memiliki kebutuhan sumber daya yang berbeda-beda tergantung pada tugasnya. Beberapa model mungkin memerlukan memori yang lebih besar, sementara yang lain lebih membutuhkan kecepatan pemrosesan throughput yang tinggi. Mengatur bagaimana setiap model ini ditempatkan dalam infrastruktur server agar tidak terjadi bottleneck adalah sebuah tantangan teknis yang besar. Tanpa sistem orkestrasi yang cerdas, penggunaan sumber daya bisa menjadi sangat tidak efisien, yang pada akhirnya akan meningkatkan biaya operasional secara signifikan.
Konsistensi dan Monitoring Performa Secara Real-Time
Menjaga agar setiap model dalam armada tetap berperforma maksimal memerlukan sistem pemantauan yang sangat detail dan responsif. Dalam lingkungan produksi, penurunan performa atau model drift bisa terjadi kapan saja tanpa peringatan yang jelas. Monitoring untuk Small Language Model fleets harus mampu melacak metrik latensi, akurasi, dan konsumsi energi dari setiap individu model secara real-time. Jika salah satu model dalam armada mulai menunjukkan perilaku yang tidak konsisten, sistem harus mampu melakukan failover atau routing ulang secara otomatis agar pengalaman pengguna tidak terganggu.
Membangun Arsitektur Produksi yang High-Throughput
Untuk mencapai performa yang maksimal, arsitektur produksi harus dirancang dengan fokus pada efisiensi aliran data dari awal hingga akhir. Strategi yang umum digunakan adalah dengan menerapkan lapisan load balancing yang cerdas yang mampu mendistribusikan permintaan pengguna ke model yang paling relevan dan tersedia. Arsitektur ini harus mampu menangani lonjakan trafik yang tiba-tiba tanpa menyebabkan sistem mengalami crash atau peningkatan latensi yang tidak wajar. Pendekatan modular sangat disarankan agar setiap bagian dari sistem dapat ditingkatkan skalanya secara independen sesuai dengan kebutuhan beban kerja.
- Model Routing: Sistem cerdas yang mengarahkan input pengguna ke model yang paling sesuai berdasarkan konteks permintaan.
- Dynamic Scaling: Kemampuan untuk menambah atau mengurangi jumlah instans model secara otomatis berdasarkan volume trafik.
- Resource Pooling: Berbagi sumber daya komputasi di antara beberapa model untuk memaksimalkan utilitas perangkat keras.
- Asynchronous Processing: Menggunakan antrean pesan untuk menangani tugas-tugas yang tidak memerlukan respons instan guna menjaga stabilitas sistem.
Implikasi Bagi Industri dan Masa Depan Implementasi AI
Keberhasilan dalam membangun arsitektur untuk Small Language Model fleets akan membawa dampak yang sangat luas bagi berbagai sektor industri. Perusahaan tidak lagi bergantung pada satu penyedia model besar yang mahal, melainkan dapat memiliki ekosistem AI milik sendiri yang lebih lincah dan hemat biaya. Dampak ini akan sangat terasa pada industri yang membutuhkan pemrosesan data cepat di lokasi (edge computing), seperti manufaktur pintar, kendaraan otonom, dan perangkat IoT medis. Dengan model yang lebih kecil dan arsitektur yang tepat, integrasi AI ke dalam kehidupan sehari-hari akan menjadi semakin masif dan tidak terlihat.
Ke depannya, kita bisa mengharapkan munculnya alat-alat baru yang dirancang khusus untuk mengotomatisasi manajemen armada model ini. Fokus pengembangan kemungkinan besar akan bergeser dari sekadar meningkatkan parameter model ke arah optimasi infrastruktur dan efisiensi energi. Inovasi dalam bidang arsitektur produksi ini akan menjadi kunci utama yang membedakan perusahaan yang sukses mengadopsi AI dengan mereka yang tertinggal di tahap eksperimen. Penggunaan SLM yang terorkestrasi dengan baik bukan hanya soal teknologi, melainkan soal bagaimana memberikan nilai tambah yang maksimal bagi pengguna akhir dengan cara yang paling efisien.
Kesimpulan dan Pandangan ke Depan
Membangun arsitektur produksi untuk Small Language Model fleets adalah langkah krusial berikutnya dalam evolusi teknologi kecerdasan buatan. Meskipun saat ini industri masih menghadapi kebuntuan dalam hal standarisasi manajemen armada model, potensi manfaat yang ditawarkan oleh SLM dalam hal kecepatan, biaya, dan kustomisasi sangatlah besar untuk diabaikan. Para pengembang harus mulai berpikir melampaui sekadar fine-tuning dan mulai memfokuskan energi mereka pada desain sistem yang skalabel dan andal. Keberhasilan dalam menjembatani kesenjangan antara model yang canggih dan infrastruktur produksi yang efisien akan menentukan arah perkembangan AI di tahun-tahun mendatang.
Sebagai penutup, penting untuk diingat bahwa teknologi AI yang paling efektif bukanlah yang memiliki parameter paling banyak, melainkan yang dapat diimplementasikan secara stabil dan memberikan solusi nyata bagi masalah manusia. Dengan terus berkembangnya teknik orkestrasi dan manajemen model, penggunaan Small Language Model akan menjadi standar baru dalam pengembangan perangkat lunak modern. Kita sedang memasuki era di mana kecerdasan buatan tidak lagi menjadi sesuatu yang eksklusif dan mahal, melainkan menjadi komponen dasar yang terintegrasi secara efisien di setiap lini kehidupan digital kita.