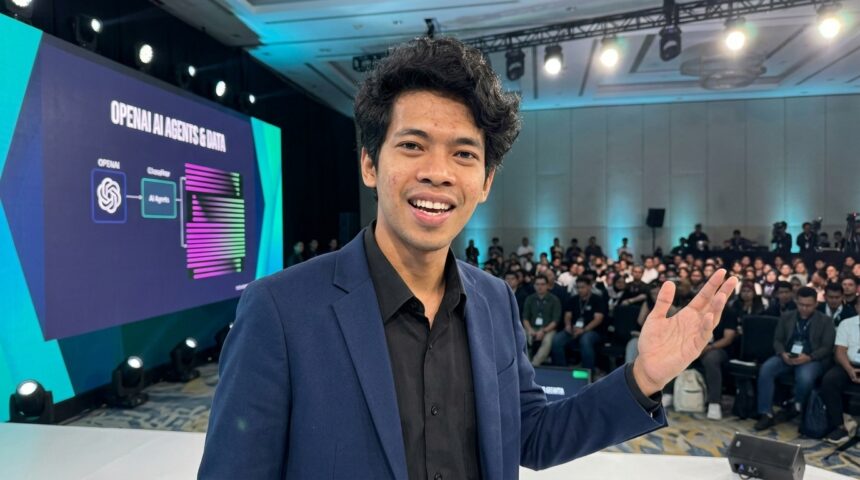
Dunia teknologi baru saja mendapatkan bocoran berharga mengenai bagaimana raksasa kecerdasan buatan, OpenAI, mengelola infrastruktur data mereka yang sangat masif. Dalam sebuah presentasi mendalam, Bonnie Xu mengungkapkan eksistensi Kepler, sebuah agen AI analis data internal yang dirancang khusus untuk menavigasi lautan informasi sebesar 600 petabyte. Ini bukan sekadar alat kueri biasa; Kepler merepresentasikan lompatan besar dalam Human-AI Collaboration, di mana mesin tidak lagi hanya menunggu perintah, tetapi secara aktif memahami struktur data yang kompleks untuk menyajikan wawasan yang akurat bagi para peneliti dan engineer di OpenAI.
Kebutuhan akan Kepler muncul dari tantangan nyata yang dihadapi oleh tim internal OpenAI dalam mengelola dataset yang terus membengkak. Dengan volume data mencapai ratusan petabyte, metode analisis tradisional sudah tidak lagi memadai. Kepler hadir sebagai solusi Inovasi Teknologi yang mampu menjembatani celah antara bahasa manusia yang ambigu dengan struktur database yang kaku. Melalui implementasi teknik canggih, agen ini mampu melakukan tugas-tugas berat mulai dari eksplorasi data hingga penulisan kode kueri yang optimal, memastikan bahwa setiap bit informasi dapat dimanfaatkan untuk pengembangan model AI masa depan.
Mengintip Kecanggihan Teknis Kepler: Melampaui Batasan Context Window
Salah satu hambatan terbesar dalam menggunakan Large Language Models (LLM) untuk analisis data skala besar adalah keterbatasan context window. Bonnie Xu menjelaskan bahwa memberikan seluruh skema database ke dalam model adalah hal yang mustahil. Untuk mengatasi hal ini, OpenAI mengintegrasikan Model Context Protocol (MCP) yang memungkinkan Kepler untuk secara dinamis mengambil informasi yang relevan saja. Dengan cara ini, agen tetap memiliki konteks yang tajam tanpa harus terbebani oleh informasi yang tidak perlu, meningkatkan efisiensi Data Processing secara signifikan.
Selain MCP, Kepler juga memanfaatkan teknik RAG (Retrieval-Augmented Generation) yang telah disesuaikan. Sistem ini memungkinkan agen untuk mencari dokumentasi internal dan metadata secara real-time sebelum mengeksekusi kueri. Dengan menggabungkan pengetahuan statis model dengan data dinamis dari infrastruktur OpenAI, Kepler mampu meminimalisir halusinasi dan memberikan jawaban yang didasarkan pada fakta keras yang ada di dalam gudang data mereka. Pendekatan ini membuktikan bahwa Strategi Data yang tepat sangat krusial dalam membangun sistem AI yang handal.
Automated Code Crawling dan Pemahaman Skema Otomatis
Kepler tidak hanya membaca data, tetapi juga memahami bagaimana data tersebut dibuat melalui automated code crawling. Agen ini mampu menelusuri repositori kode internal untuk memahami logika di balik setiap tabel dan kolom. Dengan memahami aliran data dari hulu ke hilir, Kepler dapat memberikan interpretasi yang jauh lebih mendalam dibandingkan analis manusia yang mungkin hanya melihat permukaan saja. Ini adalah bentuk nyata dari Modernisasi Industri dalam bidang analitik.
Scoped Semantic Memory: Rahasia Kepler Bisa Belajar Secara Mandiri
Hal yang paling mengesankan dari Kepler adalah kemampuannya untuk memiliki Scoped Semantic Memory. Berbeda dengan model AI standar yang ‘lupa’ setelah sesi berakhir, Kepler memiliki memori jangka panjang yang terorganisir. Ia merekam pola kueri yang sukses, memahami preferensi pengguna, dan menyimpan solusi untuk masalah teknis yang pernah dihadapi sebelumnya. Teknik self-learning ini memastikan bahwa Kepler menjadi semakin cerdas dan efisien seiring dengan semakin seringnya ia digunakan oleh tim OpenAI.
Memori semantik ini memungkinkan Kepler untuk membangun semacam ‘peta mental’ dari seluruh ekosistem data OpenAI. Jika seorang engineer menanyakan hal yang serupa dengan kueri di masa lalu, Kepler tidak perlu memulai dari nol. Ia akan mengambil referensi dari memorinya, menyesuaikannya dengan parameter baru, dan memberikan hasil dalam hitungan detik. Implementasi Machine Learning dalam manajemen memori agen ini adalah standar baru dalam pengembangan Enterprise AI.
Membangun Kepercayaan Melalui Akurasi Data yang Tinggi
Dalam dunia analitik, akurasi adalah segalanya. OpenAI sangat menyadari hal ini dan membekali Kepler dengan kemampuan untuk melakukan verifikasi mandiri. Sebelum menyajikan hasil akhir, Kepler seringkali menjalankan simulasi kecil atau kueri validasi untuk memastikan bahwa data yang ditarik konsisten dengan ekspektasi logis. Hal ini sangat penting untuk menjaga integritas riset di dalam perusahaan yang menjadi pionir Artificial Intelligence global ini.
Evaluasi Ketat Menggunakan AST-Based LLM Grading
Bagaimana OpenAI memastikan Kepler tidak melakukan kesalahan fatal? Jawabannya terletak pada sistem evaluasi berbasis Abstract Syntax Tree (AST). Bonnie Xu menekankan bahwa mereka tidak hanya mengandalkan penilaian subjektif, tetapi menggunakan grading otomatis yang sangat teknis. Dengan membedah struktur kode yang dihasilkan Kepler ke dalam bentuk AST, sistem evaluasi dapat memverifikasi secara objektif apakah logika kueri tersebut benar, efisien, dan aman untuk dijalankan di infrastruktur produksi.
Pendekatan ini menciptakan pipeline evaluasi yang bebas regresi. Setiap kali ada pembaruan pada model dasar Kepler, sistem akan mengujinya terhadap ribuan test case yang sudah ada menggunakan grading AST tersebut. Jika performa menurun atau ditemukan potensi error, update tersebut tidak akan dirilis. Standar Software Development yang sangat ketat ini menjamin bahwa Kepler tetap menjadi alat yang bisa diandalkan sepenuhnya oleh para analis data OpenAI dalam menjalankan Manajemen Risiko informasi.
Menghindari Halusinasi dengan Validasi Berbasis Kode
Dengan menggunakan grading berbasis AST, OpenAI dapat mendeteksi jika Kepler mencoba menggunakan fungsi atau tabel yang tidak eksis—masalah umum pada LLM yang sering berhalusinasi. Sistem grading ini bertindak sebagai ‘polisi’ yang memastikan setiap baris kode yang dihasilkan oleh agen AI memiliki landasan teknis yang kuat. Belum ada konfirmasi resmi mengenai apakah teknologi evaluasi ini akan dirilis untuk publik, namun dampaknya bagi Kualitas Kode internal sangatlah nyata.
Dampak Kepler Terhadap Masa Depan Analisis Data dan Industri AI
Kehadiran Kepler memberikan gambaran nyata tentang bagaimana Masa Depan pekerjaan analis data akan berubah. Kita sedang bergerak menuju era di mana manusia bertindak sebagai konduktor, sementara agen AI seperti Kepler melakukan pekerjaan berat dalam penarikan dan pemrosesan data. Dampaknya bagi Industri Teknologi sangat luas; perusahaan tidak lagi memerlukan waktu berhari-hari untuk mendapatkan jawaban dari dataset mereka, melainkan hanya dalam hitungan menit melalui interaksi bahasa alami dengan agen pintar.
Perbandingan dengan kompetitor menunjukkan bahwa OpenAI selangkah lebih maju dalam mengintegrasikan AI ke dalam alur kerja internal mereka sendiri. Sementara banyak perusahaan masih berjuang dengan integrasi database dasar, OpenAI sudah berhasil mengotomatisasi analisis pada skala petabyte. Ini memberikan keunggulan kompetitif yang masif dalam hal kecepatan iterasi produk dan akurasi pengambilan keputusan strategis. Transformasi Digital yang dilakukan OpenAI melalui Kepler adalah cetak biru bagi perusahaan modern lainnya.
- Efisiensi Operasional: Mengurangi beban kerja manual analis data hingga lebih dari 60%.
- Skalabilitas: Mampu menangani pertumbuhan data hingga skala exabyte tanpa penurunan performa signifikan.
- Aksesibilitas: Memungkinkan staf non-teknis untuk mendapatkan wawasan data yang kompleks tanpa harus menguasai SQL tingkat mahir.
- Keamanan: Integrasi dengan protokol keamanan internal memastikan data sensitif tetap terlindungi selama proses kueri.
Outlook: Menuju Integrasi AI Agent yang Lebih Luas
Melihat kesuksesan Kepler, besar kemungkinan OpenAI akan terus mengembangkan kapabilitas agen ini untuk mencakup lebih banyak aspek dalam Ekosistem Digital mereka. Di masa depan, kita mungkin akan melihat agen AI yang tidak hanya menganalisis data, tetapi juga memberikan rekomendasi strategis secara proaktif berdasarkan tren yang mereka temukan di dalam dataset raksasa tersebut. Konsep Human-AI Collaboration akan semakin erat, di mana batasan antara alat dan rekan kerja menjadi semakin tipis.
Secara keseluruhan, presentasi Bonnie Xu tentang Kepler adalah pengingat bahwa di balik kecanggihan ChatGPT yang kita gunakan sehari-hari, terdapat infrastruktur data dan agen AI internal yang luar biasa rumit. Keberhasilan Kepler dalam mengelola 600 petabyte data membuktikan bahwa dengan arsitektur yang tepat—seperti penggunaan MCP, RAG, dan memori semantik—AI dapat menjadi analis yang jauh lebih hebat dari yang pernah kita bayangkan sebelumnya. Kita sedang berada di ambang revolusi analitik yang akan mengubah cara dunia memandang dan menggunakan data selamanya.