Ekosistem Retrieval-Augmented Generation atau yang lebih dikenal dengan istilah RAG telah mengalami pendewasaan teknologi yang luar biasa cepat dalam beberapa tahun terakhir. Kita kini berada di era di mana vector database sudah masuk ke tahap produksi massal (production-grade), sementara model embedding menjadi semakin terjangkau dan efisien dibandingkan sebelumnya. Pipeline pengambilan data ini bukan lagi sekadar eksperimen laboratorium, melainkan sudah diimplementasikan secara luas di berbagai sektor krusial seperti layanan kesehatan, industri keuangan, sistem hukum, hingga platform edukasi global. Hampir setiap laporan industri dan riset akademis menunjukkan angka-angka performa yang sangat impresif, memberikan kesan bahwa teknologi ini telah mencapai kematangan sempurna.
Namun, di balik kegemilangan angka-angka tersebut, terdapat sebuah rahasia umum yang mulai meresahkan para pakar: hampir semua tolok ukur atau benchmark utama yang digunakan untuk mengukur kehebatan AI saat ini dilakukan dalam bahasa Inggris. Dominasi bahasa Inggris dalam pengujian AI menciptakan apa yang disebut sebagai ‘The Benchmark Trap’ atau jebakan tolok ukur. Hal ini menjadi masalah besar yang jarang dibahas secara terbuka, padahal dampaknya sangat signifikan bagi akurasi informasi yang diterima oleh pengguna non-bahasa Inggris. Tanpa adanya pengujian yang komprehensif dalam berbagai bahasa, klaim mengenai kehebatan sebuah sistem AI sebenarnya hanyalah representasi dari satu sisi dunia saja.
Memahami Fenomena RAG: Revolusi yang Terancam Bias Linguistik
Secara teknis, Retrieval-Augmented Generation bekerja dengan cara menghubungkan model bahasa besar (LLM) dengan sumber data eksternal yang tepercaya untuk memberikan jawaban yang lebih akurat dan faktual. Dengan menggunakan vector database, sistem dapat mencari informasi yang paling relevan dari ribuan dokumen dalam hitungan milidetik. Keunggulan inilah yang membuat RAG menjadi pilihan utama bagi perusahaan yang ingin meminimalisir ‘halusinasi’ pada AI. Namun, efektivitas sistem ini sangat bergantung pada kemampuan model embedding untuk memahami nuansa semantik dalam teks yang diolahnya.
Masalah muncul ketika kita menyadari bahwa sebagian besar model embedding dan dataset pelatihan yang tersedia saat ini sangat condong ke arah bahasa Inggris. Ketika sebuah bank di Indonesia atau rumah sakit di Jepang menggunakan sistem RAG yang dilatih dengan standar bahasa Inggris, terjadi penurunan kualitas pemahaman konteks yang sangat tajam. Hal ini bukan sekadar masalah terjemahan kata per kata, melainkan kegagalan sistem dalam menangkap struktur logika dan budaya unik dari bahasa non-Inggris. Belum ada konfirmasi resmi mengenai seberapa besar kerugian finansial akibat kesalahan interpretasi data lintas bahasa ini, namun potensi risikonya sangat nyata.
Dampak Nyata pada Sektor Finansial dan Hukum
Dalam dunia hukum dan keuangan, ketepatan satu kata saja bisa mengubah seluruh makna dari sebuah kontrak atau laporan audit. Penggunaan RAG dalam sektor ini bertujuan untuk mempercepat analisis dokumen yang sangat tebal, namun ketergantungan pada benchmark bahasa Inggris membuat sistem sering kali gagal mendeteksi anomali dalam bahasa lokal. Jika sistem AI hanya diuji menggunakan dataset bahasa Inggris, maka performanya di lapangan saat menghadapi dokumen hukum berbahasa Indonesia mungkin tidak akan seakurat yang dijanjikan di atas kertas. Hal ini menciptakan risiko kepatuhan dan keamanan data yang seharusnya menjadi prioritas utama bagi pengembang teknologi.
Jebakan Tolok Ukur: Mengapa Angka Tinggi Bisa Menyesatkan
Banyak pengembang AI sering kali membanggakan skor tinggi pada pengujian standar seperti MMLU atau HumanEval untuk menunjukkan superioritas model mereka. Masalahnya, pengujian ini tidak mencerminkan tantangan nyata dalam skenario cross-lingual atau lintas bahasa yang sering dihadapi oleh pengguna global. Sebuah model mungkin mendapatkan skor 95% dalam tugas pengambilan data berbahasa Inggris, namun skor tersebut bisa anjlok hingga di bawah 60% saat diuji dengan bahasa yang memiliki struktur berbeda. Ketimpangan ini sering kali diabaikan demi mengejar angka-angka pemasaran yang terlihat bagus bagi investor dan calon klien.
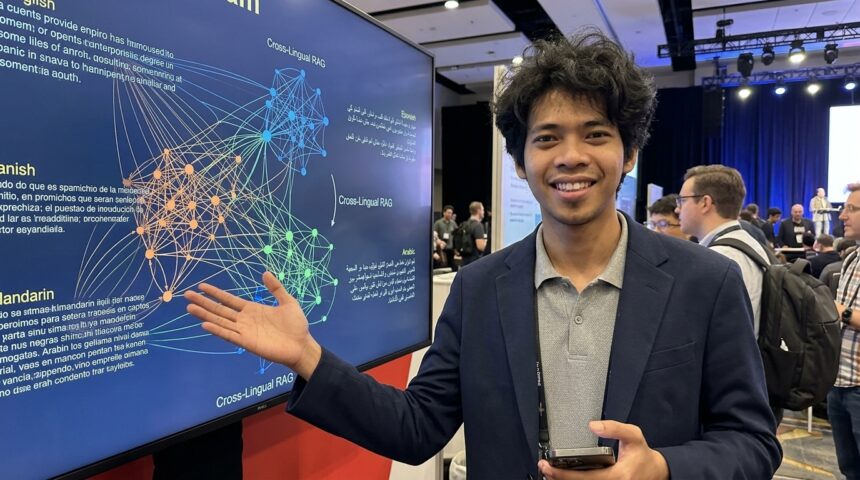
Kesenjangan ini disebut sebagai masalah cross-lingual RAG yang hingga kini masih menjadi gajah di dalam ruangan (elephant in the room). Para peneliti cenderung berfokus pada optimasi performa dalam bahasa Inggris karena ketersediaan dataset yang melimpah dan biaya komputasi yang lebih murah. Akibatnya, inovasi dalam bahasa-bahasa ‘minoritas’ secara digital menjadi terhambat, meskipun jumlah penuturnya di dunia nyata sangatlah besar. Industri teknologi seolah-olah sedang membangun menara tinggi di atas fondasi yang hanya kokoh di satu sisi, sementara sisi lainnya masih rapuh dan belum teruji dengan benar.
- Dominasi Data: Mayoritas data pelatihan berasal dari sumber berbahasa Inggris di internet.
- Biaya Embedding: Model embedding multilingual yang berkualitas tinggi sering kali lebih mahal dan sulit diakses.
- Kurangnya Dataset Lokal: Dataset berkualitas tinggi dalam bahasa non-Inggris masih sangat langka untuk kebutuhan benchmarking.
- Ilusi Performa: Skor pengujian yang tinggi dalam satu bahasa tidak menjamin efektivitas dalam bahasa lain.
Tantangan Teknis: Masalah Embedding Lintas Bahasa
Model embedding adalah jantung dari setiap sistem RAG, karena model inilah yang bertanggung jawab untuk mengubah teks menjadi representasi numerik dalam ruang vektor. Jika model ini tidak dilatih dengan pemahaman lintas bahasa yang kuat, maka dokumen dalam bahasa Indonesia mungkin tidak akan dianggap relevan dengan kueri dalam bahasa Inggris, atau sebaliknya. Masalah cross-lingual ini sangat kompleks karena melibatkan pemetaan konsep yang sama di antara dua atau lebih bahasa yang berbeda secara struktural. Tanpa integrasi yang mendalam, sistem RAG hanya akan menjadi alat yang sangat terbatas bagi perusahaan multinasional.
Selain itu, aspek teknis lainnya yang sering terlupakan adalah bagaimana Natural Language Processing (NLP) menangani dialek dan bahasa formal versus non-formal. Di banyak negara, bahasa yang digunakan dalam dokumen resmi sangat berbeda dengan bahasa yang digunakan dalam komunikasi sehari-hari. Model AI yang hanya memahami standar bahasa Inggris sering kali gagal melakukan pemetaan semantik yang tepat untuk dokumen-dokumen lokal tersebut. Hal ini menuntut adanya pendekatan baru dalam pengembangan model machine learning yang lebih inklusif terhadap keberagaman linguistik global.
“Kita tidak bisa membangun kecerdasan buatan yang benar-benar universal jika kita hanya mengandalkan satu bahasa sebagai tolok ukur keberhasilan. Masa depan AI terletak pada kemampuannya untuk memahami konteks lokal secara mendalam.”
Perbandingan: Model Global vs Kebutuhan Lokal
Jika kita membandingkan performa model AI global milik perusahaan besar dengan model yang dikembangkan secara lokal, terlihat perbedaan strategi yang mencolok. Model global biasanya memiliki keunggulan dalam hal skala dan kecepatan, namun sering kali kehilangan nuansa saat dihadapkan pada data spesifik daerah. Sebaliknya, model lokal mungkin memiliki dataset yang lebih relevan, tetapi sering kali kekurangan dukungan infrastruktur dan pendanaan untuk mencapai skalabilitas tingkat dunia. Persaingan ini seharusnya memicu kolaborasi, bukan sekadar perlombaan untuk mendominasi satu bahasa saja.
Teknologi generative AI saat ini memang sangat memukau, namun kita harus tetap kritis terhadap klaim-klaim yang ada. Pengguna di industri Healthcare AI, misalnya, tidak bisa mentoleransi kesalahan sekecil apa pun dalam interpretasi catatan medis pasien hanya karena sistem gagal memahami istilah medis dalam bahasa lokal. Oleh karena itu, penting bagi para pengambil kebijakan dan pemimpin teknologi untuk mulai menuntut transparansi mengenai bagaimana sistem AI diuji dalam konteks lintas bahasa sebelum benar-benar diimplementasikan secara luas.
Pandangan ke Depan: Menuju Ekosistem AI yang Lebih Inklusif
Masa depan Retrieval-Augmented Generation harus bergeser dari sekadar pengejaran skor benchmark bahasa Inggris menuju penciptaan sistem yang benar-benar multibahasa. Hal ini memerlukan investasi besar dalam pembuatan dataset lokal yang berkualitas serta pengembangan metodologi pengujian baru yang lebih adil. Kita perlu melihat lebih banyak inisiatif terbuka (open-source) yang berfokus pada penguatan kemampuan AI dalam memahami bahasa-bahasa di luar bahasa Inggris agar manfaat teknologi ini dapat dirasakan secara merata oleh seluruh umat manusia tanpa terkecuali.
Sebagai penutup, tantangan cross-lingual RAG adalah pengingat bahwa teknologi tidak pernah bebas dari konteks sosial dan budaya. Meskipun kemajuan teknis dalam vector database dan embedding sangat menjanjikan, keberhasilan sejatinya akan diukur dari sejauh mana teknologi tersebut mampu melayani kebutuhan masyarakat global yang beragam. Para pengembang dan peneliti harus mulai melangkah keluar dari zona nyaman bahasa Inggris dan menghadapi realitas linguistik dunia jika ingin menciptakan kecerdasan buatan yang benar-benar transformatif dan adil bagi semua orang.